Blog
ChatGPT Web Sitenizi Nasıl Bulur? OAI-SearchBot, GPTBot ve Teknik Erişim
ChatGPT’nin web sitenizi bulması, modelin bir gün sitenizi “öğrenmesini” beklemekten ibaret değildir. ChatGPT Search güncel web kaynaklarını kullanabildiği için sitenin teknik olarak keşfedilebilir olması, OpenAI’nin arama crawler’ına erişim vermesi ve önemli içeriğin alınabilir biçimde sunulması gerekir.
Burada ilk ayrım oldukça önemlidir:
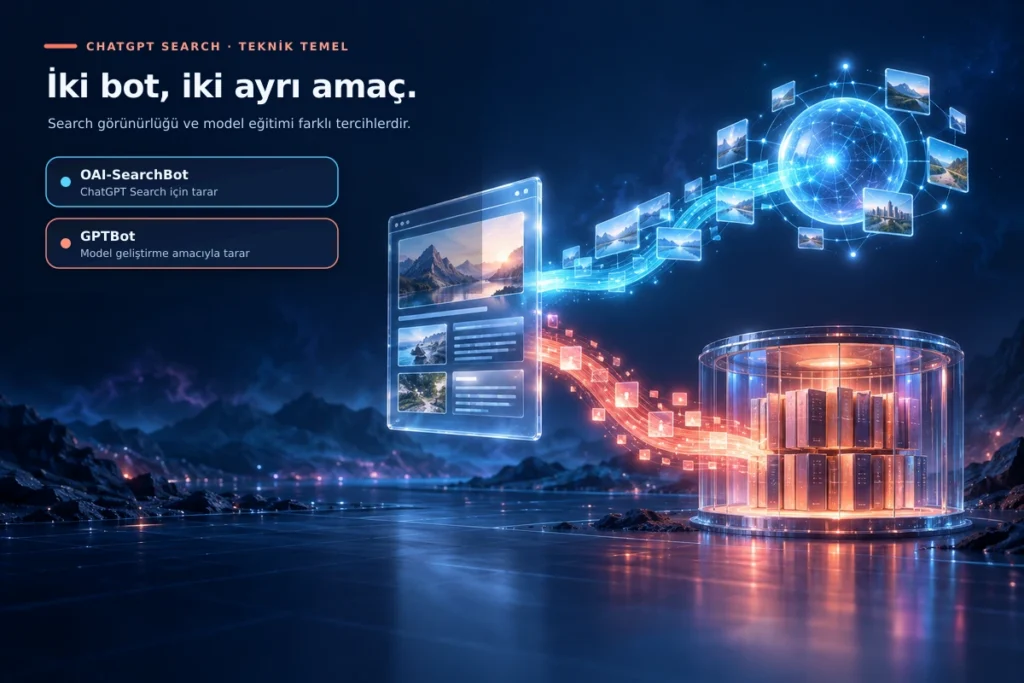
OAI-SearchBot ile GPTBot aynı bot değildir.
OAI-SearchBot, ChatGPT’nin arama özelliklerinde web sayfalarının bulunması ve sonuçlarda kaynak olarak kullanılabilmesi için kullanılan crawler’dır. GPTBot ise OpenAI’nin generative AI modellerinin geliştirilmesinde kullanılabilecek içeriği tarayan ayrı bir bottur.
Bu nedenle:
“GPTBot’u engellersem ChatGPT’de görünmem.”
genel olarak doğru değildir.
Bir site OAI-SearchBot’a erişim verirken GPTBot’u engelleyebilir. OpenAI bu iki tercihin birbirinden bağımsız olduğunu açıkça belirtiyor.
ChatGPT Search görünürlüğü sizin için önemliyse odaklanmanız gereken teknik crawler öncelikle OAI-SearchBot‘tur.
Ancak crawler erişimi yalnız ilk kapıdır. Bir sayfanın erişilebilir olması onun mutlaka citation alacağı veya markanızın önerileceği anlamına gelmez. Bu nedenle konu yalnız robots.txt dosyasına indirgenmemelidir.
ChatGPT Bir Web Sitesini Nasıl Keşfeder?
ChatGPT Search güncel sorulara cevap verirken web üzerinde arama yapabilir ve cevaplarının yanında kaynak bağlantıları gösterebilir. Bir web sitesinin bu sistem içinde kullanılabilmesi için öncelikle sayfalarının keşfedilebilir ve alınabilir olması gerekir.
OpenAI, herkese açık web sitelerinin ChatGPT Search sonuçlarında görünebileceğini belirtiyor. Site sahipleri açısından temel kontrol noktalarından biri OAI-SearchBot erişimidir.
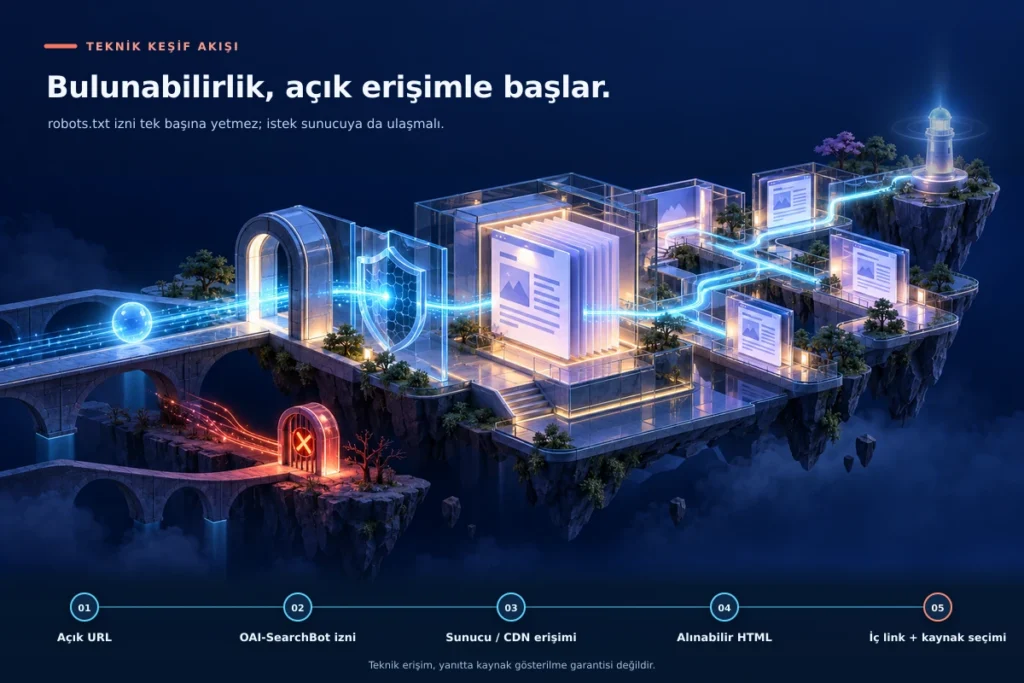
Teknik akışı basitleştirirsek:
URL Discovery → OAI-SearchBot Access → Content Fetch → Search Retrieval → Source Selection → ChatGPT Answer
şeklinde düşünülebilir.
Burada önemli bir ayrım var. Crawler’ın sayfanızı alabilmesi, sonraki bütün aşamalarda seçileceğiniz anlamına gelmez.
Sayfanız teknik olarak erişilebilir olabilir ama sorguyla yeterince ilgili olmayabilir. Bilgi yüzeysel olabilir. Rakip kaynaklar daha güncel veya daha güçlü olabilir. Marka ile hizmet arasındaki ilişki yeterince açık olmayabilir.
Dolayısıyla ChatGPT görünürlüğünü yalnız crawler kontrolüyle açıklamak, Google SEO’sunu yalnız robots.txt kontrolüne indirgemek kadar eksik olur.
Bu teknik katman klasik SEO’daki crawl ve rendering problemleriyle önemli ölçüde kesişir. DigitalPlus’ın Teknik SEO çalışmalarında da URL’nin yalnız tarayıcıda açılmasına değil; kaynak HTML, rendering, internal links, canonical ve erişim katmanlarının birlikte çalışmasına bakılmasının nedeni budur.
OAI-SearchBot Nedir?
OAI-SearchBot, OpenAI’nin ChatGPT arama özellikleri için kullandığı web crawler’dır.
OpenAI’nin resmi crawler dokümantasyonuna göre OAI-SearchBot’un görevi web sitelerinin ChatGPT Search sonuçlarında gösterilebilmesini sağlamaktır.
Bir site OAI-SearchBot’u engellerse içerikleri ChatGPT Search cevaplarında normal kaynak olarak gösterilmeyebilir.
Bu yüzden web sitenizin ChatGPT Search’te keşfedilmesini istiyorsanız robots.txt, CDN, firewall veya bot koruma sistemlerinizin OAI-SearchBot’u engellemediğini kontrol etmek mantıklıdır.
Fakat burada sık yapılan bir hata var:
robots.txt açık = görünürlük var
denklemine geçmek.
OAI-SearchBot erişimi yalnız teknik uygunluğu sağlar.
ChatGPT’nin bir cevapta sitenizi kullanması için sorgu ilişkisi, kaynak seçimi, bilgi kalitesi, güncellik ve başka sinyaller de rol oynayabilir.
Dolayısıyla bot erişimini açmak bir “GEO optimizasyonu tamamlandı” checkbox’ı değil, temel teknik gereksinimlerden biridir.
OAI-SearchBot ile GPTBot Arasındaki Fark Nedir?
İki botun karıştırılması gereksiz robots.txt değişikliklerine yol açabiliyor.
| Bot | Ana görev | Search görünürlüğü açısından rolü |
|---|---|---|
| OAI-SearchBot | ChatGPT Search için web içeriğini keşfetmek | Doğrudan ilgili |
| GPTBot | OpenAI modellerinin geliştirilmesinde kullanılabilecek içeriği taramak | Search görünürlüğü kontrolü değildir |
| ChatGPT-User | Kullanıcının ChatGPT içinde istediği belirli web sayfalarını ziyaret etmek | Otomatik Search crawler’ı değildir |
Bu ayrım site sahiplerine önemli bir kontrol verir.
Örneğin şirketiniz ChatGPT Search’te bulunmak istiyor ancak içeriğinin model eğitimi amacıyla GPTBot tarafından taranmasını istemiyorsa iki bot için farklı robots.txt kuralları uygulayabilir.
Yani:
Search görünürlüğü tercihi ile training tercihi aynı karar değildir.
Bu ayrımın yanlış kurulması özellikle hukuk, yayıncılık ve kurumsal içerik ekiplerinde gereksiz kafa karışıklığı yaratabilir.
ChatGPT-User Nedir?
OpenAI’nin web erişiminde yalnız otomatik crawler’lar bulunmaz.
ChatGPT-User, kullanıcının ChatGPT veya bir Custom GPT üzerinden belirli bir web sayfasıyla etkileşime geçmesini gerektiren durumlarda kullanılabilen ayrı bir user agent’tır.
Örneğin kullanıcı ChatGPT’den belirli bir URL’yi incelemesini isteyebilir.
Bu trafik otomatik web crawling ile aynı değildir.
OpenAI, ChatGPT-User’ın Search’te hangi içeriğin gösterileceğine karar vermek için kullanılmadığını belirtiyor. Search görünürlüğünü yönetmek için robots.txt tarafında esas kontrol OAI-SearchBot’tur.
Ayrıca kullanıcı tarafından tetiklenen isteklerin doğası nedeniyle robots.txt kurallarının ChatGPT-User’a her durumda aynı şekilde uygulanmayabileceği OpenAI dokümantasyonunda belirtilmektedir.
Dolayısıyla üç botu tek “ChatGPT botu” başlığı altında değerlendirmek yanlış olur.
ChatGPT Search İçin robots.txt Nasıl Ayarlanmalı?
ChatGPT Search’te bulunmak isteyen bir web sitesinde en temel kontrol, OAI-SearchBot’un ilgili URL’lere erişiminin yanlışlıkla engellenmemesidir.
Basit bir izin örneği şöyledir:
User-agent: OAI-SearchBot
Allow: /
Eğer site sahibi Search görünürlüğünü korumak ancak GPTBot’un model geliştirme amacıyla yaptığı taramayı engellemek istiyorsa kurallar ayrı tanımlanabilir:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
Bu yapı ChatGPT Search crawler’ına izin verirken GPTBot için farklı bir tercih belirtir.
Fakat yalnız robots.txt dosyasını görmek yeterli değildir.
Gerçek erişimi ayrıca test etmek gerekir.
Çünkü OAI-SearchBot robots.txt tarafından izinli olsa bile Cloudflare, Akamai, WAF, bot protection veya sunucu katmanı isteği 403 ile engelleyebilir.
OpenAI bu nedenle OAI-SearchBot’un yalnız robots.txt üzerinden değil, yayınlanan IP aralıklarının güvenlik sistemleri tarafından engellenmediği açısından da kontrol edilmesini öneriyor.
Bu tam olarak klasik teknik SEO’daki “robots açık, demek crawl sorunu yok” hatasına benzer. DigitalPlus’ın SEO Audit yaklaşımında da tek bir etikete bakmak yerine gerçek HTTP davranışı, crawl sonucu ve canlı sayfa birlikte doğrulanır.
Cloudflare veya WAF OAI-SearchBot’u Engelleyebilir mi?
Evet.
Birçok web sitesi DDoS, scraping ve kötü niyetli otomasyonu azaltmak için bot koruma sistemleri kullanıyor.
Bu sistemler bazen meşru crawler’ları da otomatik trafik olarak sınıflandırabilir.
Sonuç olarak robots.txt:
Allow: /
diyor olabilir ancak OAI-SearchBot gerçek URL’ye ulaştığında 403 Forbidden alabilir.
Bu yüzden teknik QA sırasında yalnız dosyadaki kuralı değil, gerçek request sonucunu kontrol etmek gerekir.
OpenAI OAI-SearchBot için güncel IP aralıklarını yayınlıyor. Güvenlik ekibi gerekiyorsa bu aralıkları kullanarak botun gerçekten OpenAI altyapısından gelip gelmediğini doğrulayabilir ve uygun allowlist politikasını oluşturabilir.
IP aralıkları değişebileceği için internette bir blog yazısından alınmış statik IP listesini sonsuza kadar firewall’a yapıştırmak da pek parlak bir altyapı kararı olmaz. Güncel resmi liste esas alınmalıdır.
robots.txt Değişikliği Ne Kadar Sürede Etki Eder?
robots.txt dosyasını değiştirdikten sonra sonucu saniyeler içinde değerlendirmemek gerekir.
OpenAI, Search sistemlerinin robots.txt değişikliklerine uyum sağlamasının yaklaşık 24 saat sürebileceğini belirtiyor.
Bu nedenle OAI-SearchBot’u bugün açıp beş dakika sonra ChatGPT’ye şirketinizi sorarak:
“Çalışmadı.”
sonucuna varmak sağlıklı test değildir.
Ayrıca erişimin sağlanması görünürlük garantisi olmadığı için değişiklik sonrası değerlendirme yalnız marka adı sorusuyla yapılmamalıdır.
Teknik değişiklikten sonra log, HTTP response ve bot erişimi kontrol edilmeli; visibility tarafında ise daha geniş query seti zaman içinde tekrar ölçülmelidir.
robots.txt ile noindex Aynı Şey mi?
Hayır.
robots.txt crawler’ın URL’ye erişmesini kontrol eder.
noindex ise erişilen sayfanın indeks veya sonuç yüzeylerinde kullanılmaması yönünde ayrı bir direktiftir.
Buradaki ince nokta şudur: crawler sayfaya hiç giremiyorsa HTML içindeki noindex etiketini de okuyamaz.
OpenAI’nin yayıncı rehberinde, engellenmiş bir URL başka kaynaklardan keşfedilirse bazı durumlarda yalnız bağlantı ve başlığın gösterilebileceği belirtiliyor. Bunun da istenmediği durumda noindex kullanılabileceği, fakat botun etiketi okuyabilmesi için sayfaya erişiminin olması gerektiği açıklanıyor.
Bu nedenle:
“robots.txt ile engelledim, artık URL hiçbir yerde görünmez.”
varsayımı fazla basittir.
Google tarafında da robots, noindex, canonical ve indexation birbirinden ayrı teknik kavramlardır. DigitalPlus’ın Google İndeksleme Sorunları Rehberi bu aşamaları keşif, crawling ve indexation olarak ayrı ele alır.
Canonical ve noindex’in farklı problemleri çözdüğünü daha ayrıntılı anlamak için Canonical Audit rehberine de bakabilirsiniz.
ChatGPT JavaScript ile Oluşturulan İçeriği Görebilir mi?
Burada kesin olmayan noktayı kesinmiş gibi anlatmamak gerekir.
OpenAI’nin resmi OAI-SearchBot dokümantasyonu crawler’ın JavaScript rendering kapasitesi için Googlebot benzeri ayrıntılı bir rendering garantisi yayınlamıyor.
Bu nedenle kritik içeriği yalnız client-side JavaScript çalıştıktan sonra ortaya çıkan yapıya bırakmak, ChatGPT Search görünürlüğü açısından güvenli bir varsayım değildir.
Bir sayfanın tarayıcıda kullanıcıya düzgün görünmesi, crawler’ın aynı içeriği aynı biçimde alabildiğini kanıtlamaz.
Özellikle:
- ana metin
- ürün veya hizmet adı
- fiyat ve özellik bilgileri
- canonical
- metadata
- internal links
yalnız JavaScript çalıştıktan sonra oluşturuluyorsa kaynak HTML ile render edilmiş DOM arasındaki fark kontrol edilmelidir.
Bu yalnız ChatGPT için oluşturulmuş özel bir teknik kural değildir.
JavaScript ağırlıklı sitelerde rendering zaten temel Teknik SEO çalışma alanlarından biridir. DigitalPlus’ta gerektiğinde ilk HTML çıktısını, render edilmiş HTML’yi, internal link üretimini, metadata’yı ve canonical davranışını ayrı ayrı kontrol etmemizin nedeni budur.
En güvenli yaklaşım önemli bilginin mümkün olduğunca erişilebilir HTML içinde bulunması ve yalnız kullanıcı tarafındaki JavaScript çalışmasına bağımlı bırakılmamasıdır.
Client-Side Rendering ChatGPT Görünürlüğünü Engeller mi?
Her client-side rendered site otomatik olarak görünmez değildir.
Problem kullanılan framework’ün adı değil, önemli bilginin crawler tarafından gerçekten alınıp alınamadığıdır.
React, Vue, Next.js veya başka bir framework kullanmak tek başına SEO problemi değildir.
Ancak ilk HTML neredeyse boşsa ve bütün anlamlı içerik, bağlantılar ve metadata sonradan browser JavaScript’iyle oluşturuluyorsa farklı crawler’ların sayfayı nasıl işlediği ayrıca test edilmelidir.
Bu nedenle:
“Next.js kullanıyoruz, sorun yok.”
veya:
“React kullanıyoruz, ChatGPT bizi göremez.”
gibi iki uç genelleme de doğru değildir.
Teknik karar gerçek HTML çıktısı üzerinden verilmelidir.
PDF Dosyaları ChatGPT Tarafından Bulunabilir mi?
Web üzerindeki PDF’ler önemli bir konu çünkü birçok B2B şirket teknik kataloglarını, araştırmalarını, şartnamelerini veya ürün dokümantasyonunu yalnız PDF olarak yayınlıyor.
Burada iki farklı senaryoyu birbirinden ayırmak gerekir.
Bir kullanıcının doğrudan ChatGPT’ye PDF yüklemesi veya belirli bir PDF üzerinde çalışması başka bir kullanım biçimidir.
Web üzerindeki PDF’nin OAI-SearchBot tarafından keşfedilip Search içinde nasıl değerlendirileceği ise web crawling ve source-selection problemidir.
OpenAI’nin mevcut crawler dokümantasyonu PDF’ler için Google Search Central seviyesinde ayrıntılı bir “PDF indexing specification” yayınlamıyor.
Bu nedenle işletme açısından kritik bilgiyi yalnız PDF içinde bırakmamak daha güvenli bir içerik mimarisidir.
Örneğin ürününüzün teknik kataloğu PDF ise:
HTML ürün veya teknik dokümantasyon sayfası → temel bilgiler → PDF doküman linki
şeklinde bir yapı kurulabilir.
Böylece temel ürün adı, teknik özellikler, kullanım alanı, versiyon veya doküman açıklaması doğrudan HTML üzerinde bulunur; PDF ise daha ayrıntılı kaynak olarak sunulur.
Bu yapı yalnız ChatGPT için değil klasik Search, accessibility, internal linking ve kullanıcı deneyimi açısından da daha sağlamdır.
PDF’yi robots.txt ile Engellemek Fark Yaratır mı?
PDF URL’leri de web kaynağıdır ve URL path seviyesindeki robots.txt kuralları bu dosyalara erişimi etkileyebilir.
Örneğin bütün teknik dokümanları:
/documents/
altında tutuyor ve bu klasörü crawler’lara kapatıyorsanız ilgili dosyaların doğrudan alınmasını da engelleyebilirsiniz.
Bu yüzden web sitenizde HTML dışında PDF, doküman veya medya dosyaları önemli bilgi taşıyorsa crawler erişimini yalnız sayfa URL’leri açısından değil, kaynak dosyalar açısından da düşünmek gerekir.
ChatGPT İçin XML Sitemap Gerekli mi?
OpenAI’nin mevcut Search yönergelerinde Google Search Console’daki gibi ayrı bir sitemap gönderme veya URL indexing request sistemi tanımlanmıyor.
Dolayısıyla ChatGPT’ye özel bir “sitemap gönder” süreci varmış gibi davranmak doğru değildir.
Bununla birlikte düzgün site mimarisi ve internal linking önemini kaybetmez.
Önemli URL’lerin sitenin navigasyonu, category/hub yapısı ve contextual internal linkler üzerinden keşfedilebilir olması hem kullanıcılar hem farklı crawler sistemleri açısından sağlıklı bir web mimarisidir.
DigitalPlus’ın Teknik SEO hizmetinde XML sitemap’i internal linking ve site mimarisinden ayrı değerlendirmememizin nedeni budur. Bir URL’nin sitemap’te bulunması onu otomatik olarak güçlü ve keşfedilebilir bir sayfa yapmaz.
Benzer şekilde SEO Audit sırasında orphan page’lerin ve tarama derinliğinin kontrol edilmesi, önemli sayfaların yalnız dosya listelerinde değil gerçek site ağında yer alıp almadığını anlamaya yardımcı olur.
Internal Linking ChatGPT’nin Sitenizi Bulmasına Yardımcı Olur mu?
Internal linking’i doğrudan “ChatGPT ranking faktörü” olarak tanımlamak için resmi bir dayanak yoktur.
Fakat site içinde önemli sayfalara gerçek HTML bağlantıları vermenin daha temel bir işlevi vardır: URL’lerin keşfedilebilir olmasını ve aralarındaki bilgi ilişkisinin açık şekilde kurulmasını sağlar.
Örneğin teknik bir hizmet sayfanız bulunuyor ancak sitedeki hiçbir sayfa bu URL’ye bağlantı vermiyorsa sayfa kullanıcı açısından da crawler açısından da izole kalır.
Daha sağlıklı yapı:
Service Owner ↔ Supporting Content ↔ Related Guide ↔ Case Study
ilişkisini gerçek internal links üzerinden kurmaktır.
DigitalPlus’ın SEO Danışmanlığı modelinde internal linking’i keyword-to-URL ownership ve site mimarisiyle birlikte yönetmemizin nedeni de budur.
ChatGPT Search tarafında da teknik hedef farklı değildir: önemli kaynakların web üzerinde gerçekten ulaşılabilir ve bağlam içinde bulunabilir olması.
ChatGPT İçin llms.txt Gerekli mi?
Şu aşamada llms.txt dosyasını ChatGPT görünürlüğünün zorunlu şartı olarak değerlendirmek için yeterli resmi dayanak yoktur.
OpenAI’nin web sitesi sahipleri için yayımladığı mevcut crawler yönergelerinde Search görünürlüğünü yönetmek için esas olarak OAI-SearchBot ve robots.txt kontrolleri açıklanıyor.
ChatGPT Search’e dahil olmak için llms.txt oluşturulması gerektiği yönünde resmi bir zorunluluk belirtilmiyor.
Bu yüzden:
llms.txt yok → ChatGPT sitenizi bulamaz
veya:
llms.txt ekledik → GEO tamamlandı
gibi iki denklem de kurulamaz.
Google da 2026 yılında yayımladığı generative AI Search rehberinde Google Search’in llms.txt dosyasını kullanmadığını açıkça belirtiyor.
Bu durum farklı şirketlerin veya gelecekteki ürünlerin llms.txt için hiçbir zaman kullanım geliştirmeyeceği anlamına gelmez. Fakat bugün bir web sitesinin teknik öncelikleri arasında robots erişimi, önemli içeriğin alınabilir olması, site mimarisi ve gerçek bilgi kalitesi varken bütün GEO çalışmasını llms.txt dosyasına bağlamak ters önceliklendirme olur.
Bu nedenle ilk aşamada ayrı bir llms.txt içerik owner’ı açmak yerine konuyu burada, gerçek teknik bağlamı içinde açıklamak daha sağlıklıdır.
ChatGPT İçin Özel Schema Kullanmak Gerekir mi?
OpenAI’nin Search crawler dokümantasyonu ChatGPT görünürlüğü için özel bir “AI schema” tanımlamıyor.
Structured data yine ürün, organizasyon, yerel işletme, makale veya diğer gerçek entity’leri ifade etmek için kullanılabilir.
Ancak:
Schema → ChatGPT citation garantisi
gibi bir ilişki kurulamaz.
Aynı problem klasik SEO’da da görülür. Structured data içeriğin yerine geçmez, yalnız sayfadaki gerçek bilgiyi daha yapılandırılmış şekilde ifade etmeye yardımcı olabilir.
Bir site teknik olarak onlarca schema tipi eklemiş olabilir ama ana hizmetlerinin ne olduğu, hangi sayfanın hangi intent’i sahiplenmesi gerektiği veya kullanıcıya hangi özgün bilgiyi sunduğu hâlâ belirsiz olabilir.
ChatGPT Search İçin noindex Kullanılmalı mı?
Bu tamamen hedefe bağlıdır.
Bir URL’nin ChatGPT Search’te içerik olarak kullanılmasını istemiyorsanız erişim ve index kontrolünü bilinçli şekilde yönetmeniz gerekir.
OpenAI’nin yayıncı dokümantasyonuna göre yalnız OAI-SearchBot’u engellemek bazı durumlarda URL’nin başka kaynaklardan keşfedilip yalnız bağlantı ve başlık olarak gösterilmesini tamamen önlemeyebilir.
Bir URL’nin bu şekilde de gösterilmesini istemiyorsanız noindex kullanılabilir.
Fakat crawler noindex etiketini okuyabilmek için sayfaya erişebilmelidir.
Bu nedenle robots ve noindex kararları birbirinden bağımsız düşünülmemelidir.
Teknik kontrol gerektiren bu tür durumlarda SEO Audit yaklaşımındaki bulgu → teşhis → aksiyon ayrımı oldukça kullanışlıdır. Bir URL’yi engellemeden önce gerçekten neyi engellemek istediğinizi tanımlamak gerekir.
ChatGPT Sitenizi Bulabiliyor mu? Nasıl Test Edilir?
ChatGPT’ye marka adınızı yazıp cevapta çıkıp çıkmadığını görmek teknik test değildir.
Önce erişim katmanını ayrı doğrulamak gerekir.
robots.txt içinde OAI-SearchBot için blok olup olmadığını kontrol edin. CDN veya WAF üzerinde OpenAI crawler trafiğinin engellenmediğini doğrulayın. Sunucu loglarında OAI-SearchBot request’leri bulunuyorsa HTTP yanıtlarını inceleyin.
Ardından önemli URL’leri kontrol edin.
200 dönüyorlar mı? Canonical doğru mu? İçerik kaynak HTML’de bulunuyor mu? Sayfanın ana bilgisi yalnız kullanıcı etkileşiminden sonra mı geliyor? Internal links gerçekten HTML anchor olarak üretiliyor mu?
Bunlar büyük ölçüde klasik teknik crawling sorularıdır.
DigitalPlus’ın Teknik SEO yaklaşımında bir sayfayı değerlendirirken kaynak HTML, render edilmiş HTML, HTTP durumu, canonical ve internal linking’i gerektiğinde birlikte incelememizin sebebi budur.
Daha geniş bir teknik veya mimari problemden şüpheleniyorsanız SEO Audit ile crawl verisini, Search Console’u ve canlı site davranışını birlikte değerlendirmek daha anlamlı olabilir.
OAI-SearchBot Gelmiyorsa Sorun Ne Olabilir?
Botu robots.txt içinde açık bırakmış olmanız gerçek erişimin sağlandığını kanıtlamaz.
Olası problem güvenlik katmanında olabilir. CDN crawler’ı otomatik bot olarak engelliyor olabilir. Sunucu belirli IP bloklarını reddedebilir. URL 5xx dönüyor olabilir. Sonsuz redirect zinciri veya auth duvarı bulunabilir.
Bu nedenle gerçek teknik teşhis:
robots.txt → firewall/CDN → HTTP response → page content
zincirini takip etmelidir.
SEO Audit araçlarında görünen her uyarının gerçek problem olmadığı gibi, robots dosyasında gördüğünüz her izin kuralı da gerçek erişim kanıtı değildir. DigitalPlus’ın SEO Audit hatalarını önceliklendirme rehberinde de otomatik bulgu ile doğrulanmış teknik problemin birbirinden ayrılması gerektiğini bu nedenle vurguluyoruz.
OAI-SearchBot’u Engellersem ChatGPT Markamı Hiç Göstermez mi?
Bu sorunun cevabı “tamamen yok olur” kadar basit değildir.
OpenAI’nin resmi açıklamasına göre OAI-SearchBot’tan çıkmayı seçen siteler ChatGPT Search cevaplarında normal kaynak olarak gösterilmez.
Ancak OpenAI URL’yi başka bir sağlayıcıdan veya başka web sayfalarını tarayarak öğrenirse bazı durumlarda yalnız navigational bağlantı ve sayfa başlığı sunabilir.
Bu ayrım önemli çünkü:
Search source inclusion
ile:
URL’nin herhangi bir bağlamda bilinmesi
aynı şey değildir.
GPTBot’u Engellemek SEO’yu veya ChatGPT Search’ü Bozar mı?
OpenAI’nin resmi dokümantasyonuna göre OAI-SearchBot ve GPTBot tercihleri bağımsızdır.
Dolayısıyla GPTBot’u engellemeniz tek başına OAI-SearchBot’un Search için sitenizi taramasını engellemez.
Bu yüzden model training tercihi ile ChatGPT Search görünürlüğü tercihini aynı robots satırında çözmeye çalışmamak gerekir.
Kurumsal şirketlerin hukuk, içerik ve SEO ekipleri bu iki kararı ayrı değerlendirebilir.
ChatGPT’de Görünmek İçin Sitem Google’da İndeksli Olmak Zorunda mı?
ChatGPT Search ile Google Search aynı indeks değildir.
Bu nedenle Google’da indeksli olmak teknik olarak ChatGPT Search inclusion garantisi değildir; Google’da indeksli olmamak da tek başına OpenAI’nin web crawler davranışını tanımlamaz.
Fakat pratikte bir sitenin Google tarafında ciddi crawl, internal linking veya rendering problemleri varsa aynı teknik zayıflıkların başka crawler’lar için de problem yaratması şaşırtıcı olmaz.
Bu yüzden “Google tarafını bırakıp yalnız ChatGPT SEO yapalım” yaklaşımı çoğu site için yanlış önceliklendirmedir.
Önemli URL’leriniz Google’da bile bulunmuyor veya indekslenmiyorsa önce indeksleme probleminin hangi aşamada oluştuğunu anlamak ve temel Teknik SEO altyapısını düzeltmek daha mantıklıdır.
ChatGPT İçin Ayrı Bir Teknik SEO mu Yapmak Gerekir?
Tamamen ayrı bir teknik disiplin yaratmak çoğu site için gereksizdir.
ChatGPT Search bazı özel crawler kontrolleri ekler. OAI-SearchBot erişimi bunun en net örneğidir.
Fakat sitenin:
200 yanıt vermesi, kritik içeriğin erişilebilir HTML içinde bulunması, doğru URL’lerin internal links ile bağlanması, canonical ve metadata’nın tutarlı olması, robots kurallarının bilinçli yönetilmesi gibi ihtiyaçlar zaten sağlıklı web ve Teknik SEO altyapısının parçasıdır.
Bu nedenle DigitalPlus’ta AI Search discoverability’yi “siteye birkaç yeni AI etiketi ekleyelim” şeklinde ayrı bir teknik silo olarak ele almak yerine mevcut crawl, render, ownership ve içerik sisteminin genişleyen bir yüzeyi olarak değerlendirmek daha doğru olur.
Bu yaklaşım DigitalPlus Yöntemi ile de uyumludur: önce problemin gerçekten nerede olduğunu belirlemek, ardından yalnız gerekli katmana müdahale etmek.
ChatGPT Search İçin Teknik Kontrol Sırası Nasıl Olmalı?
Siteyi test ederken onlarca “GEO checklist” maddesine ihtiyacınız yok.
Daha kullanışlı sıra şudur:
1. URL herkese açık mı?
Login, auth veya başka erişim engeli var mı?
2. OAI-SearchBot robots.txt tarafından engelleniyor mu?
Search görünürlüğü hedefleniyorsa botun ilgili path’lere erişebilmesi gerekir.
3. WAF / CDN / sunucu botu gerçekten geçiriyor mu?
Robots izni gerçek HTTP erişimi anlamına gelmez.
4. Kritik bilgi alınabilir HTML içinde mi?
İçeriği yalnız client-side JS davranışına bırakmayın.
5. Sayfa site içinde bulunabiliyor mu?
Orphan URL yerine gerçek internal linking sistemi kullanın.
6. İçerik gerçekten kaynak olmaya değer mi?
Teknik erişim yalnız aday olmanızı sağlar. Kaynak seçimi ayrı problemdir.
Bu son aşama önemlidir. Çünkü teknik checklist bittiğinde asıl görünürlük problemi yeni başlıyor olabilir.
Sonuç: ChatGPT Web Sitenizi Nasıl Bulur?
ChatGPT Search açısından web sitenizin teknik keşfedilebilirliğini anlamanın başlangıç noktası OAI-SearchBot’tur.
OAI-SearchBot Search için, GPTBot ise model geliştirme amacıyla kullanılabilecek içerik için kullanılan ayrı crawler’lardır. İki tercih birbirinden bağımsız yönetilebilir.
Search görünürlüğü istiyorsanız yalnız robots.txt dosyasını değil, CDN, firewall ve gerçek HTTP erişimini de kontrol etmeniz gerekir.
JavaScript ağırlıklı sitelerde kritik içeriği yalnız client-side rendering’e bırakmak yerine kaynak ve render edilmiş HTML arasındaki fark doğrulanmalıdır. İş açısından önemli bilgi yalnız PDF içinde bulunuyorsa temel içeriği HTML üzerinde de sunmak daha güvenli bir web mimarisidir.
llms.txt ise bugün ChatGPT Search görünürlüğünün zorunlu şartı olarak değerlendirilmemelidir. OpenAI’nin mevcut yayıncı yönergelerinde Search erişiminin esas teknik kontrolü OAI-SearchBot üzerinden açıklanıyor.
Özetle:
Public Access → OAI-SearchBot → Server/CDN Access → Accessible Content → Internal Discovery → Useful Source → Search Visibility
zinciri birlikte çalışmalıdır.
Bu zincirin robots, rendering, canonical, internal linking veya crawl tarafında nerede kırıldığını bilmiyorsanız SEO Audit ile problemi teşhis etmek; teknik darboğaz doğrulanmışsa Teknik SEO kapsamında uygulamak daha sağlıklı başlangıçtır.
Sitenin teknik altyapısı sağlam ancak query ownership, içerik mimarisi ve sürekli search visibility yönetimi gerekiyorsa SEO Danışmanlığı ile daha geniş sistem birlikte ele alınabilir.
Berke Dalar
Berke Dalar, DigitalPlus'ta Head of SEO & Growth olarak SEO stratejisi, teknik SEO, içerik stratejisi ve organik büyüme çalışmalarını yönetmektedir. SEO süreçlerinde teknik altyapı, arama niyeti, içerik mimarisi ve performans verilerini birlikte ele alan bir yaklaşım benimser.